AHC071 解法

AHC071 で11位でした。

似た方針で実装している人を見かけなかったので記事にします。

やったこと

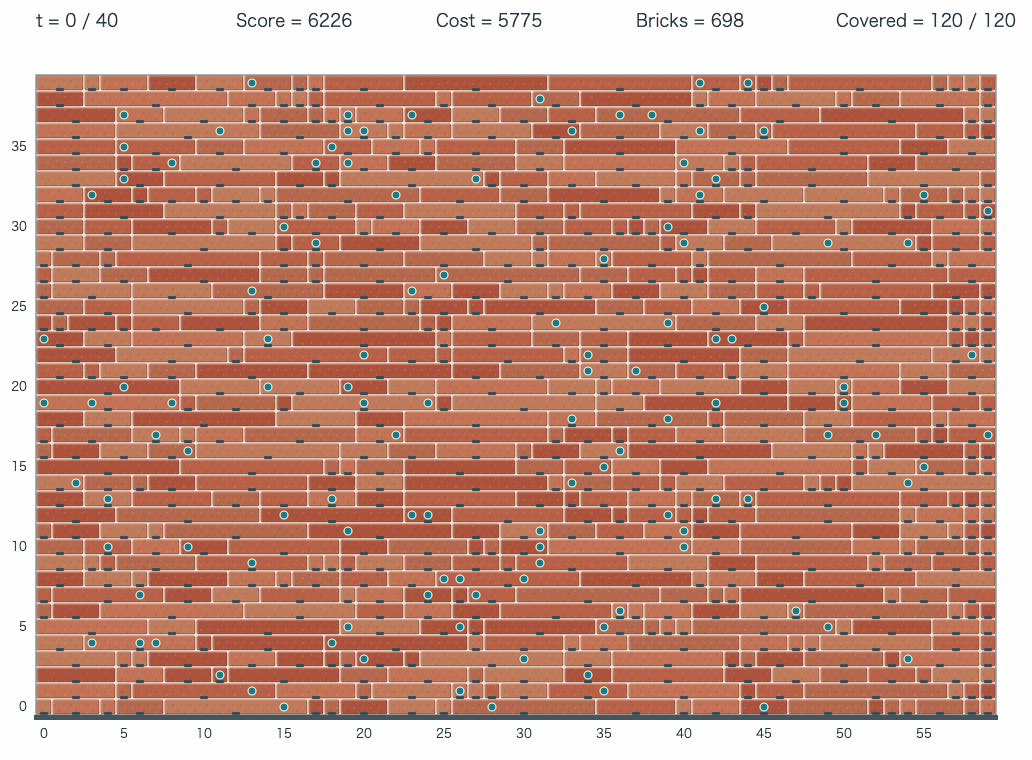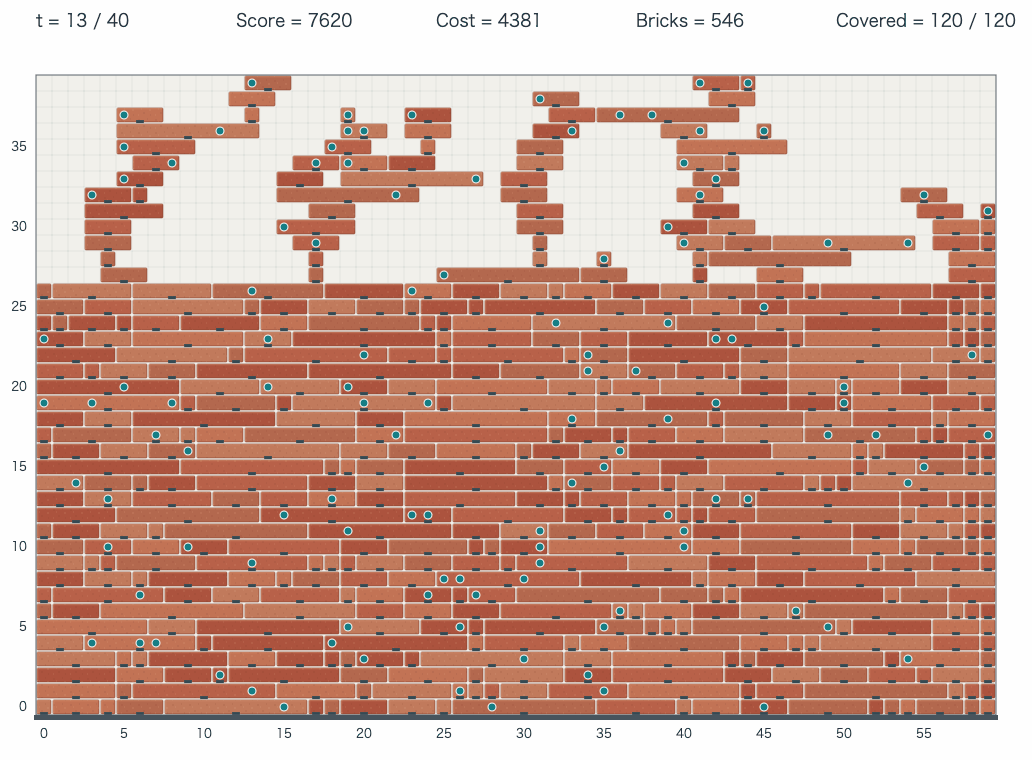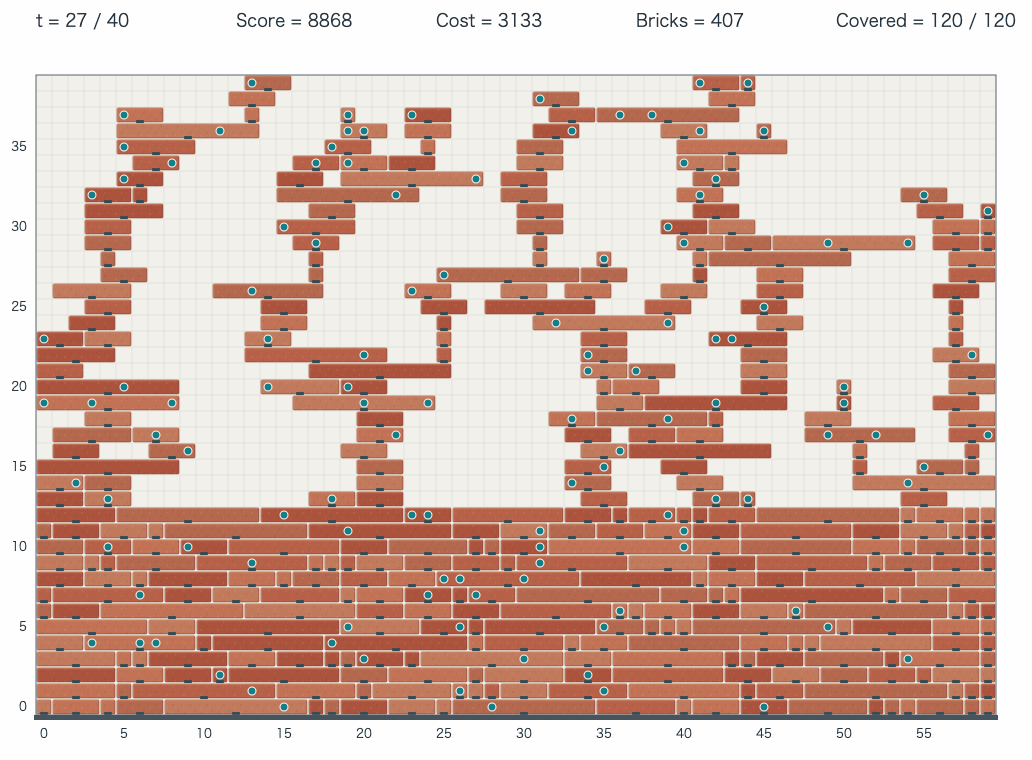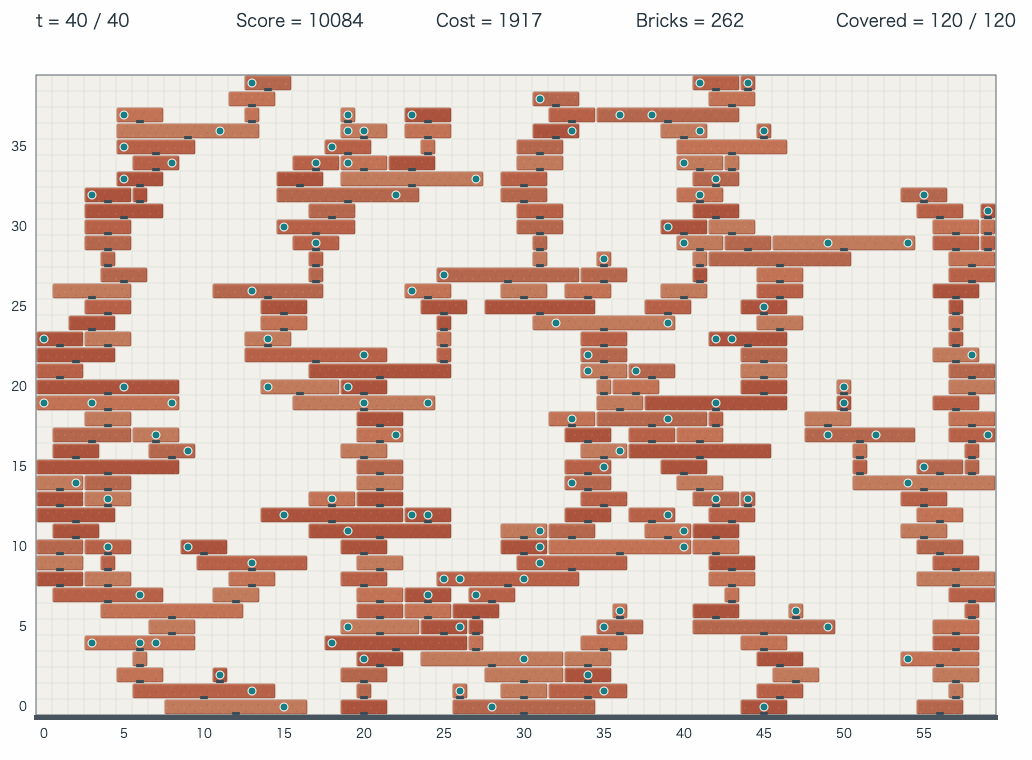
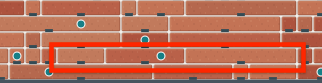
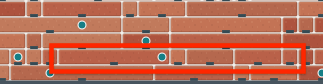
各行に仕切りを入れてレンガの置き方を決めてしまう。

いったん全部のレンガを置いたと思って、必要なものだけ残すという考え方。

1行ずつ、仕切りの入れ方をランダムに決めてコストを計算するのを何回か試して必要コスト最小のものを選んでいくことで乱択貪欲ができる。

20:25:04 1557417点 の提出 はこれ

仕切りの位置の決め方は、左から順に見ていって残り長さに収まる範囲で長さ1,3,5,7,9からランダムに1つ選んでいく。

これで初期解を作って、焼きなましをする。

行をランダムに選んで、連続する仕切りを何個か取り除いて、取り除いた範囲に仕切りをランダムに入れ直す。 そして再計算したスコアに従って遷移する。

→

以下の高速化をする。

  • 変えた行より上の部分は再計算しない
  • 変えた行より下は、上から1行ずつどのレンガを使うかシミュレーションして、変化前と同じになったら以降は再計算しない
  • 計算途中でコストが変更前のコストよりも大幅に悪くなったら枝刈りする
  • 各レンガを使うべきかどうかは、カバーすべき位置を64bit整数1つで持ってビット演算で判定

考えていたこと

上から1行ずつレンガの置き方を決めていけて、素直にやればビームサーチになる。

けど焼きなませるんだったら基本焼いた方が強いし、ビームサーチの実装を素早くやる訓練していないしなので、局所的な変更を考える。

一番シンプルな状態の持ち方は行ごとにどういうレンガを使ったかを持つもので、それに対して小さな変更を加えるとなると1つのレンガのサイズを変えたり位置をずらしたりすることだろう。 けどそれだけだとinvalidな状態になってしまうのでどう対応するかが難しいし、複数のレンガが隣接していたときに衝突して連鎖的に変更が必要…みたいになるのも大変。

扱いやすい形で解の情報を持ちたい。

使っていない場所も含めてレンガをこう置くという形を決めるとこれは各行に仕切りを入れるという形で表現できて、その仕切りの位置をずらすことで小さい変更とできる。validな状態を確実に実現できるのが良い。

1行の状態を変えたとき、下のほうの行で使う必要のあるレンガが変わって、その変化は基本的にコスト的には悪い方向になる(変化前の状態で最適化されてるはずなので)から、その点であまり良い近傍ではないような気もするけど、概算すると数十万回は遷移を試せそうだったのでそれだけの回数試せるのならいけるのでは、と判断した(実際は高速化して900万回くらい回った)。 過去問でも "その遷移で焼けるのか" と驚かされることはよくあることだし、そのパターンかなと。

壁の持ち方

AHC052 や AHC023 のように、グリッドのマスの間に壁があるような問題について。

壁の情報は bool wall[H][W][4] として、wall[y][x][dir] が「マス (y,x) から dir 方向に壁がある」を表すようにすると扱いやすいです。

グリッドの外に出れない制約も、wall[0][x][UP] = true などのようにグリッドの最も外側のマスから外に向かう方向に壁があるとすることで自然に表現できます。

Rustでの実装例

const N: usize = 30;
const UP: usize = 0;
const RIGHT: usize = 1;
const DOWN: usize = 2;
const LEFT: usize = 3;

struct Input {
    wall: [[[bool; 4]; N]; N],
}

impl Input {
    fn new() -> Input {
        let mut sc = scanner();
        let mut wall = [[[false; 4]; N]; N];
        // vertical
        for i in 0..N {
            let row = sc.next_str().unwrap();
            for j in 0..N - 1 {
                if row.chars().nth(j).unwrap() == '1' {
                    wall[i][j][RIGHT] = true;
                    wall[i][j + 1][LEFT] = true;
                }
            }
        }
        // horizontal
        for i in 0..N - 1 {
            let row = sc.next_str().unwrap();
            for j in 0..N {
                if row.chars().nth(j).unwrap() == '1' {
                    wall[i][j][DOWN] = true;
                    wall[i + 1][j][UP] = true;
                }
            }
        }
        // 外周
        for i in 0..N {
            wall[0][i][UP] = true;
            wall[N - 1][i][DOWN] = true;
            wall[i][0][LEFT] = true;
            wall[i][N - 1][RIGHT] = true;
        }
        Input { wall }
    }
}

【追記】

graph[i][j][dir]を「(i, j)からdir方向に移動したときにどのマスに行くか(壁に当たる場合は(i, j)のまま)」って定義したり

たしかにこの形式は便利そう

【ネタバレ注意】AHCの天才貪欲練習にオススメの問題まとめ

AtCoder Heuristic Contestにおいて上位を狙うには、ビームサーチや焼きなましなどの典型的な手法を適用するだけではなく、深い考察や賢い発想によって問題の本質を突くことが(問題によってその傾向の強弱はあるものの)求められ、ときに「天才貪欲」と呼ばれます。

いったいどうやって練習をすれば天才になれるのか…というのはヒューリスティック勢共通の悩みだと思うのですが、 そこでオススメなのが、(以前の予選・本戦形式だった頃の) 日本橋ハーフマラソン本戦の問題 です。

解説が見つかりづらいというデメリットはあるのですが、この記事である程度補完できればと思います。

それでは問題の紹介です。上位を取れる解法を発想するのにどれくらい飛躍がありそうかに応じて 天才度 を★で付けています。

石油王Xの憂鬱(天才度 ★☆☆☆☆ )

第1回日本橋ハーフマラソン本戦A問題です。 atcoder.jp

スコアが売った量の2乗であることから、基本的には要求量が多い人だけを相手すれば良いことがわかります。 要求量が少ない人がいる間に、要求量が多い人に売りやすい形を作れるよう準備しましょう。

この問題のように、何かを推定して答えるわけではないインタラクティブ問題では、(プレイアウトで評価するといったことをやるにしても)貪欲の良さが重要です。

Twitterまとめ: RCO presents 日本橋ハーフマラソン 本戦 - posfie

ゲーム実況者Xのデフラグ(天才度 ★★☆☆☆ )

第2回日本橋ハーフマラソン予選 B問題です。 atcoder.jp

座標が4万個・データのあるセクタが16000個あって操作回数が4000回と、対象全てに対して操作ができるだけの回数がなく、収束しないことが前提というこのようなケースも、良い貪欲を設計できたかが特に重要になるパターンです。
1手ずつ、できるだけ大きくスコアを改善できる操作を探すのが良いです。

ちなみに延長戦トップスコアは焼きなましのようです。遷移を限定することで操作順依存を無くして差分計算できる形になるのかな?

Twitterまとめ: 第2回 RCO日本橋ハーフマラソン 予選 - posfie

ファーマーXの収穫計画(天才度 ★★☆☆☆ )

第3回日本橋ハーフマラソン予選 B問題です。 atcoder.jp

いろいろな貪欲が考えられると思います。

「0回以上手入れして収穫するという一連の行動についての、得られるスコア/操作回数」のコスパが高い操作を選ぶ、という貪欲が有効でした。 このような操作回数に制限のある設定の場合に、一般的に使える考え方だと思います。

Twitterまとめ: 第3回 RCO日本橋ハーフマラソン 予選 - posfie

3-SAT(天才度 ★★★☆☆ )

yukicoderで出題されたスコア問題です。 yukicoder.me

状態がただのbool配列で表せることからシンプルな焼きなましがまず見えるかもしれませんが、評価基準がSAT全体に対してのものではなく前からどれだけ満たせたかなので、前から順番に条件を満たせるように貪欲に状態を変更していく方針が有効でした。

コンテスト後のコメント

めくってそろえる(天才度 ★★★☆☆ )

第3回日本橋ハーフマラソン本戦 A問題です。 atcoder.jp

まず基本的な方針(順位表のまんなか辺りに716992点で同点が並んでいるところ)を合わせられないと全くスコアが出ません。

そこまで行ければあとはボーナスステージ的に、妥当な考察を積んでいければスコアが上がっていくと思います。

解説スライド があります。

Twitterまとめ: 第3回 RCO日本橋ハーフマラソン 本戦 - posfie

まわしてそろえる(天才度 ★★★★☆ )

第3回日本橋ハーフマラソン本戦 B問題です。 atcoder.jp

アルゴ的に構築をしていく実装が重い方針もありますが、そうではなく、ヒューリスティックに揃えるにはどうやればよいかを考えてみるとためになりそうな問題だと思います。 上手い評価を設計しましょう。

詳しくは 解説スライド に。

Twitterまとめ: 第3回 RCO日本橋ハーフマラソン 本戦 - posfie

日本橋大渋滞(天才度 ★★★★☆ )

第1回日本橋ハーフマラソン本戦B問題です。 atcoder.jp

シンプルな貪欲をやると大渋滞になって身動きが取れなくなるのをどう解決しますか、という問題です。
渋滞を回避してそれぞれの車がするする動いてくれる賢い戦略があります(ただし実装がそこそこ大変で、4時間とかでやろうとするものではないかもしれません)。

koyumeishiさんの解説 が詳しいです。めちゃくちゃ詰めきっててすごい…

それ以外の解法として、乱択を使って徐々に合わせていくヒューリスティックな方法もあります。コンテスト時間内にやるならこちらの方針が本線になると思います。

Twitterまとめ: RCO presents 日本橋ハーフマラソン 本戦 - posfie

ぐるぐる庭園(天才度 ★★★★★ )

第2回日本橋ハーフマラソン本戦 A問題です。 atcoder.jp

(解法の全体像を映すとビジュアライザがあまりにネタバレ過ぎるので1ターン目の画像で…)

なんとなくジグザグに動くように道を作るんだろうなというのは想像できるところで、けど良いスコアを狙うにはその中にクリティカルな天才気付きが1つ必要です。 (出題者の私は3日くらい取り組んだ時点でやっと気付きました…)
そしてそこから本番トップを超える点数を出すには、もう1つ重要な天才ポイントがあります。

簡単に 解説スライド に記載あり。

Twitterまとめ: 第2回 RCO日本橋ハーフマラソン 本戦 - posfie

魔法使いXの戦い(天才度 ★★★★★ )

日本橋ハーフマラソン2021 A問題です。 atcoder.jp

非常に重要なポイントを2つ抑えると、少しの実装でスコアが爆上がりしてびっくり、という問題です。 ヒューリスティック問題でありながらAGCの問題っぽい。

解説放送 の中で説明があります。

Twitterまとめ: 日本橋ハーフマラソン 2021 - posfie

イラストレータXと不思議なペン(天才度 ☆☆☆☆☆ )

第4回日本橋ハーフマラソン予選 B問題です。番外編。 atcoder.jp

貪欲は貪欲なんだけども、天才というより実装方針ゲーなおもむきの問題です。

  • それぞれの島まで伸ばす
  • 島の中を貪欲に塗る

という方針は比較的すぐ出ても、注意深く実装しないと違う色が向かい合って陣地取り合いバトルみたいになって詰んでしまったりします。大変。
細かい計算時間のことは気にせず、まずは富豪的に書いてみるのが取り組みやすいかなと思います。

あまりAHCではこういうタイプの問題は出題されていませんが、こういった内容をスムーズに実装できるかどうかが、どんな問題においても手数の多さに繋がってくると思います。

Twitterまとめ: 第4回 RECRUIT 日本橋ハーフマラソン 予選 - posfie

AHC042 乱択解法

AHC042 で7位が取れました。

解法としてはランダム性のあるルールベースを時間いっぱい回しただけで、焼きなましもビームサーチも評価関数設計もしていません。

似た解法で上位の人を見かけなかったので記事にしておきます。

コンテスト後に整理+少し追加で改善したソースコードです(本番6位相当)。
https://atcoder.jp/contests/ahc042/submissions/62366929

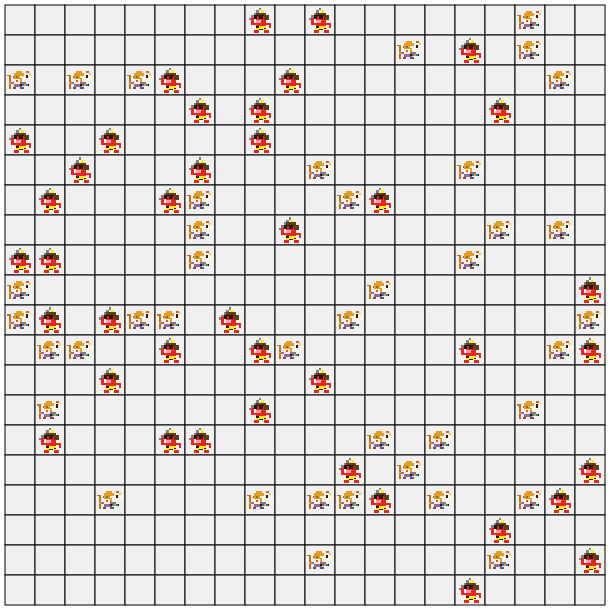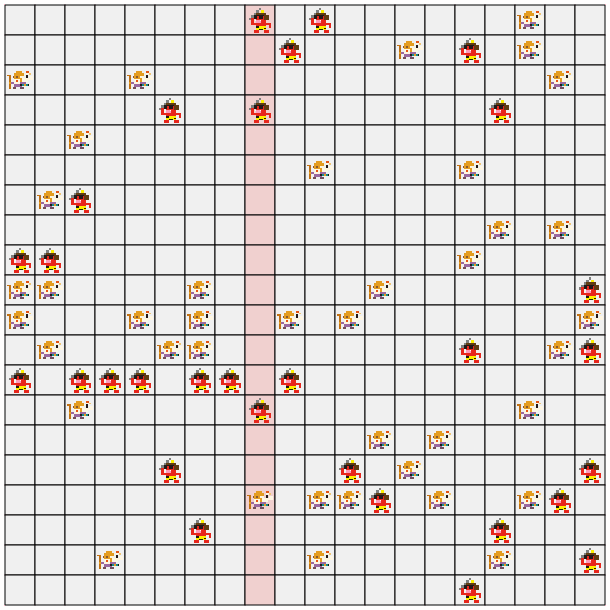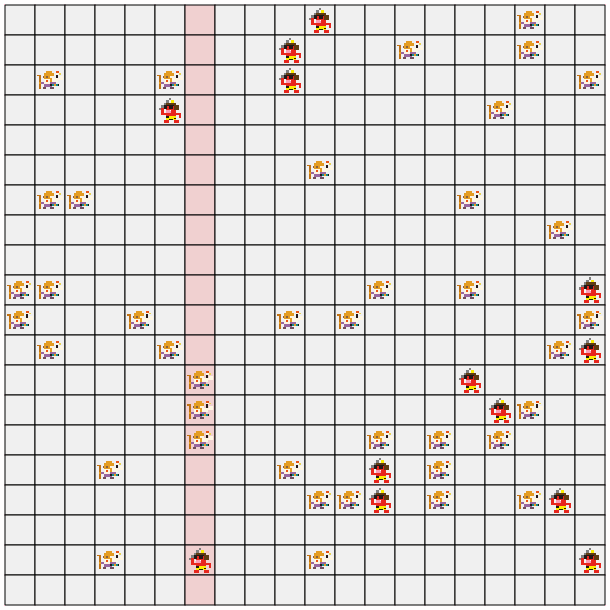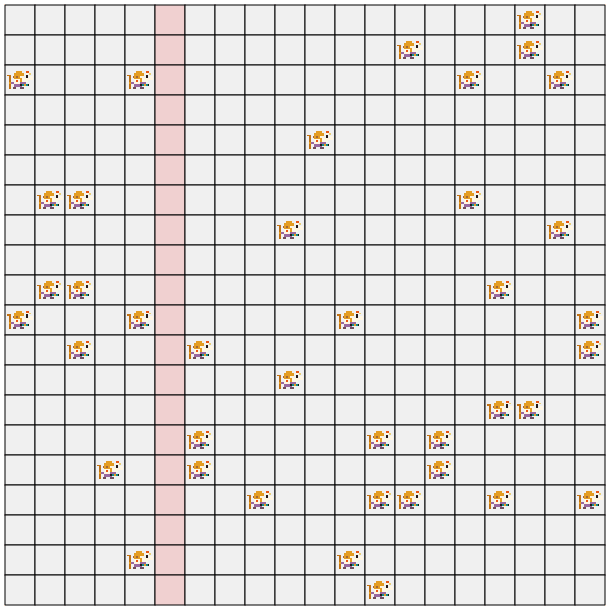
seed=0 80手

概略

  1. 盤面の座標をランダムな順で見る
  2. その座標に鬼がいれば、上下左右の近い側にシフトして追い出す
  3. 追い出そうとする向きに福がいる場合は、福を横にずらす
  4. 追い出す際に、隣の列やさらに隣の列にいる鬼を相乗りさせて一緒に動かせるならそうする
  5. 並んでる鬼を全部追い出す
  6. 鬼がいなくなるまで1.から繰り返し

これで解答を作るのを時間いっぱい繰り返して、ベストの結果を出力します。

10万回くらい回ってたみたいです。

詳細

盤面の座標をランダムな順で見る

正確には、(座標, 上下左右のうち外周への距離が最短になる向き) を全列挙します。

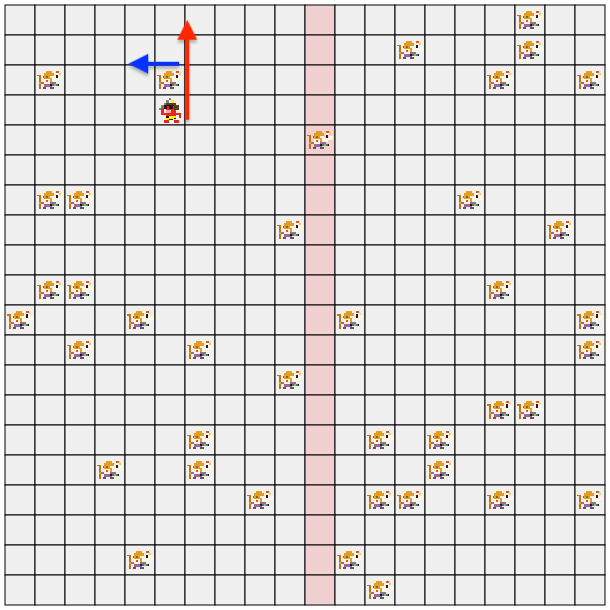
  • (0, 0) から上に追い出す
  • (0, 0) から左に追い出す
  • (0, 1) から上に追い出す
  • (0, 2) から上に追い出す
  • …
  • (N-1, N-1) から下に追い出す
  • (N-1, N-1) から右に追い出す

これをランダムに並び替えて、順に処理します。

初めは外側から順にやっていたのですが、全部ランダムにした方が圧倒的に(スコアにして1000点くらい)良かったです。

その座標に鬼がいれば、上下左右の近い側にシフトして追い出す

前のステップで作った座標に鬼がいたら、設定した向きに鬼を追い出す処理を開始します。

追い出そうとする向きに福がいる場合は、福を横にずらす

福を追い出さないよう、進行方向にいる福は横にどかします。向きはランダムに決めます。

どちらにもずらせない場合は諦めて全体を最初からやり直します。

追い出す際に、隣の列やさらに隣の列にいる鬼を相乗りさせて一緒に動かせるならそうする

できるだけ鬼をまとめて動かすことが重要(上位のスコアの80手そこらというのは、1つの鬼を追い出すのに平均2手くらいしか掛けられないということ)なので、相乗りさせます。

いま追い出そうとしている鬼を追い出すのにあと何回シフトするのかを使って、「もし隣の列にいるこの鬼を相乗りさせたら最終的にどこまで移動するか」を求め、元の位置よりどれだけ盤面の端に近付いたかを計算します。
この結果から、相乗りさせるために使った手数より得になっているかを判定し、得な場合のみ相乗りさせます。

相乗り元は、2つ隣の列まで考慮します。
上記のように1つの鬼を追い出すのに2手くらいしか掛けられないのだから、3つ以上離れたところから持ってくるのはそのためだけに3手以上かかるので、有効にはならないだろうと判断しました(試してはいない)

得になったかの判定にはランダム要素を入れます。

この相乗り操作は、追い出しの最初に1回やるのではなく、追い出すために1回シフトするたびに改めてチェックして実行可能なら実施します。
けっこう同じ計算を繰り返して無駄にもなってそうですが、これを入れないと700点くらい変わる

並んでる鬼を全部追い出す

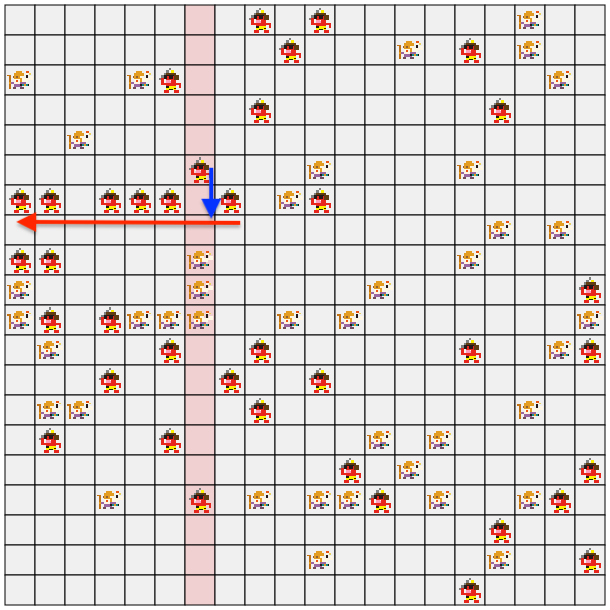
注目していた鬼の後ろにも別の鬼が連なっている場合、続けて一緒に追い出します。

上の画像のように1個空いて鬼が続いている場合、そこまでまとめて追い出すか、空いてるところで止めるかはランダムに決めます。

鬼がいなくなるまで1.から繰り返し

全部の鬼を追い出したら終了です。

盤面の座標を1周しても鬼の数が変わらなかったら、諦めて全体を最初からやり直します。

感想

本当にこれだけです。

ランダムで色々ブラすことが重要なようで、あちこちにランダム要素を入れるたびスコアが伸びました。

私のスコア問題評価環境

スコア問題の解答の評価を行う環境をAWSで組んでいます。どのようなシステムになっているかを紹介します。

費用はそこそこ抑えられていると思っていて、AHC031での実績は 1000ケース*2秒のテスト実行を165セット行って$5くらいのコストでした。

概要

AWS Batch で実行してます。

処理の詳細を順に説明します。

1. Dockerイメージをpush

採点環境となるDockerイメージをbuildしてECRにpushしておきます。

どういう環境にするかは、AtCoderの 言語アップデートのスプレッドシート を参考にするとよいかも。

イメージのエントリポイントとして、「S3から $(環境変数で指定される提出ID)/solver.zip をダウンロードして展開し、その中にあるrun.sh を実行する」というシェルスクリプトを指定しておきます。

これはコンテストごとには行わず、共通のイメージを使います。そうできるよう、エントリポイントを汎用的なものにしています。

2. テストケースをS3にアップロード

コンテスト開始時に、採点に使うテストケースを生成し、zipにまとめてS3にアップロードしておきます。

3. ソースコードをS3にアップロード

テスト実行ごとに、解答のソースコードと、テスト実行時に呼ばれる run.sh をzipにまとめてS3にアップロードします。

S3のパスは $(コンテストID)/$(日時のDDhhmm)/ としてます。日・時・分をIDにしているので1分間に複数回実行できないですが、数十秒待てばいいだけだし視認性を高める方を取りました。

run.sh の例 : https://github.com/tomerun/AHC031/blob/master/run.sh

  • 環境変数で指定された値を元に、実行するseedの範囲を定める
    • AWS_BATCH_JOB_ARRAY_INDEX は、AWS Batchの配列ジョブで設定される、自分が何番目のジョブかを表すインデックスです。これを使って、ジョブ0はseed1000~1099、ジョブ1はseed1100~1199、のように実行するテストケースを設定します。
    • だいたい 100ケース * 10並列 くらいで実行してます。
  • S3から 2. でアップロードしたテストケースをダウンロードして展開する
  • ソースコードをコンパイルする
  • 実行して log.txt にスコアなどの情報を出力する
  • log.txt をS3にアップロードする

4. 5. 6. テスト実行

aws batch submit-job のコマンドで AWS Batch にジョブを投げます。

AWS Batch は内部で自動的に適切な数のEC2インスタンスを立ち上げてジョブを実行し、終了したらインスタンスを終了してくれます。

3.でアップロードした run.sh が実行され、テストケースのダウンロード・解答の実行・結果のS3へのアップロードが行われます。

この内容は、一つ前の3.と一緒にひとつのスクリプトで実行できるようにしてます。

AWS Batchについて色々

  • コンピューティング環境の設定で、インスタンスタイプはc系のスポットインスタンスが使われるようにしてます。
    • スポットインスタンスなのでまれに強制終了されることもあるのですが、かなりまれなのであまり気にしてません。
    • どうしても防ぎたければ、オンデマンドインスタンスを使用するコンピューティング環境も作っておいてそっちに切り替えれば問題ないです。
  • EC2インスタンスを立ち上げるのに数分かかるため、その分の実行時間が余計にかかります。
    • 前回のテストが直前に実行されていればそのインスタンスを再利用してすぐ始まってくれたりはします。
    • コンテスト終了間際などで数分待つのも惜しい場合は、コンピューティング環境の設定を変えてインスタンスが常時立ち上がっているようにすることもできます。当然その分EC2の費用はかかりますが。
  • 各ジョブには2vCPUを割り振ってます。
    • 以前実験したとき、1vCPUだと実行時間が単に遅いだけでなくだいぶ不安定になっていたため、少々もったいないですがシングルスレッドでも2vCPU使ってます。
  • 同じインスタンスタイプでも、どうしてもインスタンスガチャ要素はあるようです。同じソースコードで実行しても、はっきりとした結果の優劣が出ることがたまにあります。

パラメタを振ったテストを行いたいとき

例えば焼きなましの初期温度を 1,3,10 のそれぞれで試したい場合、環境変数で INI_TEMP=1, INI_TEMP=3, INI_TEMP=10 のようにそれぞれのパラメタの値を渡したジョブをパラメタの数だけ作り、投げます。 run.sh でコンパイルするときに -DINI_TEMP=$INI_TEMP のようにして解答に反映します(コンパイル定数ではなく、解答にも環境変数で渡すようにするのもアリです)。

S3のパスは $(コンテストID)/$(日時のDDhhmm)/$(パラメタの値) のように、パラメタごとに別々のパスになるようにします。

7. 終了通知

ジョブが終了したら、そのイベントをトリガーにEventBridgeから slack webhook へリクエストすることで、ジョブの成功または失敗が自動で通知され、終了したことがすぐわかるようにしてます。

8. 結果のダウンロード

ジョブが終了したら、S3にアップロードされた実行結果をダウンロードしてきます。

aws s3 sync コマンドを使ってます。

9. 結果の分析

8.でダウンロードした結果をcutコマンドとかでなんやかんやしてスプレッドシートに入れ、好きに分析します。

スプレッドシートの例

結果はDBに入れていい感じのフロントエンドを作るとか、Google Sheetsに自動で入れるとか、手作業を減らせる方法はあるとは思うのですが、分析はアドホックに色々行いたいと思うので柔軟性を最大化したくてこうなってます(あとは普通に開発が面倒というのももちろんある)。

あと、結果はJSONLとかの構造化データになっていた方が扱いやすいとは思うのですが、解答をC++で書いたときに標準ライブラリではそういった形式に出力できないので、プレーンテキストを文字列処理する形にしてます。

補足:実行環境をAWS Lambdaにすることについて

AWS Lambda で実行すればインスタンス起動のオーバーヘッドはかなり減り、並列度を大幅に高めることもできる(AWS BatchはEC2インスタンスの起動・終了のオーバーヘッドがあるので1000ケースを1000並列で1ケースずつ実行するようなことは非現実的だが、Lambdaだとそれができる)のですが、

  • ICFPCなど、コンテストによってはLambdaの限界である15分より長く実行したい場合がある
  • インスタンスガチャ要素がAWS Batchよりさらに高そう(実験したわけではない)
  • 対vCPU時間でのコスパはAWS Batchに比べて悪い

といった理由で、採用しませんでした。

短期コンテストで使用するにはLambdaの方が良さそうではあるのですが。

BFSを繰り返すときに訪問済みかを記録する配列を毎回初期化しなくて良くするアレ

あまり広まっておらず知る人ぞ知るテクみたいになってる気がしたので。

グリッド上でBFSをするときに、単純に書くとこのような感じになると思います。

bool bfs(const vector<vector<int>>& grid, int r, int c) {
    vector<pair<int, int>> queue = { {r, c} };
    vector<vector<bool>> visited(H, vector<bool>(W));
    visited[r][c] = true;
    int qi = 0;
    while (qi < queue.size()) {
        auto [cr, cc] = queue[qi];
        for (int i = 0; i < 4; ++i) {
            int nr = cr + DR[i];
            int nc = cc + DC[i];
            if (nr < 0 || H <= nr || nc < 0 || W <= nc) continue;
            if (visited[nr][nc] || grid[nr][nc] == WALL) continue;
            if (grid[nr][nc] == GOAL) return true;
            queue.emplace_back(nr, nc);
            visited[nr][nc] = true;
        }
        qi++;
    }
    return false;
}

とりあえず、毎回メモリ確保するのを避けるため visited を毎回作らないようstaticにしましょう。

bool bfs(const vector<vector<int>>& grid, int r, int c) {
    vector<pair<int, int>> queue = { {r, c} };
    static vector<vector<bool>> visited(H, vector<bool>(W));
    for (int i = 0; i < H; ++i) {
        fill(visited[i].begin(), visited[i].end(), false);
    }
    visited[r][c] = true;
    // 以下略
}


同じBFSを何回もやるのだけど、ほとんどのケースではグリッド全体を見ることなく探索が終了するというシチュエーションがしばしばあります。
そのような場合、 visited の初期化に無視できない時間がかかり、削減したくなります。

「今回が何回目のBFSか」(下のコード中でいう bfs_cnt )を保持して、 visited を「今回のBFSで訪問したかどうか」のboolではなく、「直近で何回目のBFSで訪問したか」のintで持つようにすると、BFSのたびにH*Wの配列を初期化する必要がなくなります。

bool bfs(const vector<vector<int>>& grid, int r, int c) {
    vector<pair<int, int>> queue = { {r, c} };
    static vector<vector<int>> visited(H, vector<int>(W));
    static int bfs_cnt = 0;
    bfs_cnt++;
    visited[r][c] = bfs_cnt;
    int qi = 0;
    while (qi < queue.size()) {
        auto [cr, cc] = queue[qi];
        for (int i = 0; i < 4; ++i) {
            int nr = cr + DR[i];
            int nc = cc + DC[i];
            if (nr < 0 || H <= nr || nc < 0 || W <= nc) continue;
            if (visited[nr][nc] == bfs_cnt || grid[nr][nc] == WALL) continue;
            if (grid[nr][nc] == GOAL) return true;
            queue.emplace_back(nr, nc);
            visited[nr][nc] = bfs_cnt;
        }
        qi++;
    }
    return false;
}

HACK TO THE FUTURE 2022 本選 参加記

HACK TO THE FUTURE 2022 本選 に参加して、2位になりました。

このコンテストで高いスコアを取っていた参加者の多くが、「右手法や左手法を実現するコマンド列を作って、その繰返し回数の組合せを探索する」という解法でした。

一方、自分は右手法・左手法は作れず違う方針をとったので、どうやったのかを書き残しておきます。

天才パズルみたいに右手法左手法を賢く構築するなんて無理でしょ、という人への参考になれば。

スタート〜開始3時間時点(23376682点)

さすが本選の問題、一目ではどうやるのか全然見えないので、ビジュアライザにいろいろコマンドを打ち込んで動かしてみる。

大抵はすぐ同じ場所を動き回るだけになってしまって、繰り返しにあまり意味が無い。ただ、たまーに数十個のマスを訪問してくれるのも出てくる。

ちょっと考えて良い感じに動く一般的なコマンドを構築しようともしたけれども、すぐにはわからなかったので、 ランダムにコマンドを生成してたくさん動き回ってくれるのを探す 感じかなあ、と考える。コンピュータの計算パワーに期待しよう。

盤面サイズが20x20と小さめなのと、移動回数が5000回と少々余裕があることもあって、きっといけるだろう。

コマンドの生成方法は… 既存のコマンドの一部を変更して山登りするような方法は、途中の動きが少しでも変わるとそれ以降が全然別の動きになってしまうから、意味がなさそう。 独立にランダムに生成するしかないだろう。

繰り返しのネストを4段階まで、移動回数が指定した回数以下になるようなランダムなコマンドを作って、シミュレーションして何箇所のマスを訪問できるかを調べ、一番多いものを採用、とする。 なかなか実装が大変で、生成したコマンドの移動回数が思ってるのと微妙に違っていたりして、かなり苦しんだ。

1回のコマンドでは400マス中せいぜい320マスが訪問できる程度だったけど、そこから継続してまた別のコマンドを作ってシミュレーション… を繰り返せば、残っている未訪問マスをだんだん潰していけることもわかった。

結局、最初の解答としては次の貪欲法になった。移動回数が5000を超えないように気をつけつつ。

  • コマンドをランダム生成(移動回数1500回以下)してシミュレーションし、訪問マス数/コマンド長 の効率が最大のものを採用
  • 移動回数が4500回以下、かつ未訪問のマスがある間次を繰り返し
    • コマンドをランダム生成(移動回数200回以下)してシミュレーションし、訪問マス数/コマンド長 の効率が最大のものを採用
  • 残っている未訪問マスに1つずつ移動
    • 巡回セールスマン解くべきかもしれないけど、実装大変だし、そもそもこの部分に頼らずランダム生成だけで全マス拾えるようになるべきだして、BFSで1つずつ取っていくので十分だろうということでそうした

この時点の出力はこんな感じ(seed=0 265652点)。わけが分からない感じですね。

6(FL5(7(llFFRF)FFr)RF5(RR))8(LrlFL7(Fr)F)7(RrF6(lFFR)R)5(RFLF5(rrFL)4(rFF)FFL)30(FRll)24(Fr)6(F4(lrr3F)r)9(3FL)7(3(Ll3FR)FRF)9(FRl3FLF)9(llFFr)8(7(FFr)R)6(lL8(LrF)F)7(r6(FLFR)F)25(lFRl)7(RlLL9(FL))9(4(rFLrF)FF)8(8FL)9(RrFrF)25(lFRlF)9(4FRll)7(Rl5(lFR)R)5(F7(FlRFl)F)6(LrFFrlFr)

開始3.5時間時点(29612229点)

コマンドをランダム生成するときのパラメタをいろいろ変えて試していると、繰り返しはネストさせずに、1階層だけが一番良い結果になることがわかった。

頑張って任意階層ネストを実装していたのは一体…。

この時点の出力はこんな感じ(seed=0 276643点)。シンプルな形式になりました。

50(FFr3FLr)38(FRFLr)33(FFLFrr)22(rFrl4Fl)25(r3FLrF)38(LrRlF)38(FrllF)49(llFR)39(FLFRl)35(FlFRl)32(lFrrRF)35(FFlrr)36(lLrFR)42(RlrF)38(rFRFL)36(rrFLF)26(FFLFFrR)13(RFLllRRFLl5F)28(rFFRlFL)21(rFRRFrRrF)3(LF)24(RFlLr3F)16(RFRr3FRFFLL)54(rF)RFLFLFR5FLFR2FRFLFRFRFL2F

開始5時間時点(43527432点)

いろいろと最適化

  • コマンドの生成では n(XXXXX) の形を生成してからシミュレーションしてたけど、n回の繰り返した場合だけしか調べないのはもったいない。 XXXXX 部分だけ生成して、繰返し回数は1〜99まで全部試すようにした
    • 繰り返しのシミュレーションの途中で、一度来た場所に戻ってきたらその時点で打ち切る
  • 高速化のため、毎回コマンド生成するのではなく、最初に10000個くらいコマンドを生成しておいて使い回す

この時点の出力はこんな感じ(seed=0 442878点)。

72(Rl4FLrF)69(lFFRlFRlF)85(FlrFRll)48(R3lrFF)56(FlLr3FR)97(RlFLF)51(lFRlFLFR)44(3RrFrF)19(FrFlrRl)11(3FRll)23(rr5Fl)41(lFL3FR)

開始6時間時点(失敗)

これまでは乱択greedyなので、当然の拡張としてビームサーチにしてみた、が、遅くなるばかりで弱い…。実装頑張ったのに…

開始7.5時間時点(49205425点)

最初に手でコマンドを作って試してみてたときの事を思い出すと、10000個コマンドを生成してシミュレーションしてるけど、ほとんどのコマンドはゴミのような動きしか出来ず全然役に立っておらず、 採用されうるコマンドは偏っているのでは 、という仮説を立てた。 強そうなコマンドだけ候補として生成できれば、実質の探索速度を向上できる。

そこで、もう1つ次の仮説を立てた。

いくつかの盤面で広く動き回れるようなコマンドは、他の盤面でも有用な可能性が高い

ということで、配布されている seed=0〜9 の10個の盤面を使って、コマンドを生成・選別した。

  • ランダムにコマンドを5万個生成する
  • 10個の盤面それぞれで、 N*N 通りの各位置からスタートしてシミュレーションする。訪問できたマス数の合計を評価値とする
    • 各スタート位置について4方向それぞれでやりたかったけど、ちょっと遅すぎたのでランダムな1方向だけでやった
  • 評価値の高いほうから1万個を採用する。それらのコマンドを解答の中に埋め込んで使用する

埋め込んでる様子は コード の18行目をご覧ください。

この時点の出力はこんな感じ(seed=0 472098点)。

72(Rl4FLrF)96(rFr3lFL)78(lFLrrFRl)57(FLrFR)95(lFLrrFRl)70(FRlFRlFL)28(Frr5FL)30(FLFRrFLr)22(LrFFrFF)17(rFRFlFlr)

開始8時間=コンテスト終了時点(58758892点)

各コマンドについて繰返し回数は1〜99で試してたけど、もっと増やした方がよかった。999回まで試すようにするとスコアが跳ね上がった。数百箇所移動しないといけないのだからそりゃそうだ。

この時点の出力はこんな感じ(seed=0 555956点)。

226(FLrrFRll)39(FRlFl4F)87(FLrrFRll)55(LFrr4F)46(FLrFlrR)85(lFLrrFR)33(FFlrFRll)

感想

本選らしく、最初はどうやれば良いかわからないところ、コンテスト中の間じゅうどんどんスコアの天井が上がっていって「そこまで縮むのか」となり続けるのが面白かったです。

あとから振り返ると8時間中3時間くらいは無駄な実装に費やしていたことになるけど、やってみないとわからない部分が大きかったから何ともなあ。

ただ、最初から任意階層ネストのコマンドを作ろうとしてたのは良くなかったようには思う。まずはシンプルに始めて、良さそうな方向を見極めつつ肉付けしていくのが理想。